IA local en Codevalanche
Un modelo local, en la máquina que elijas.
Elige un entorno de ejecución local compatible o un servidor compatible para la inferencia. El tamaño del modelo, la memoria y el hardware determinan si el modelo es adecuado para tu tarea.
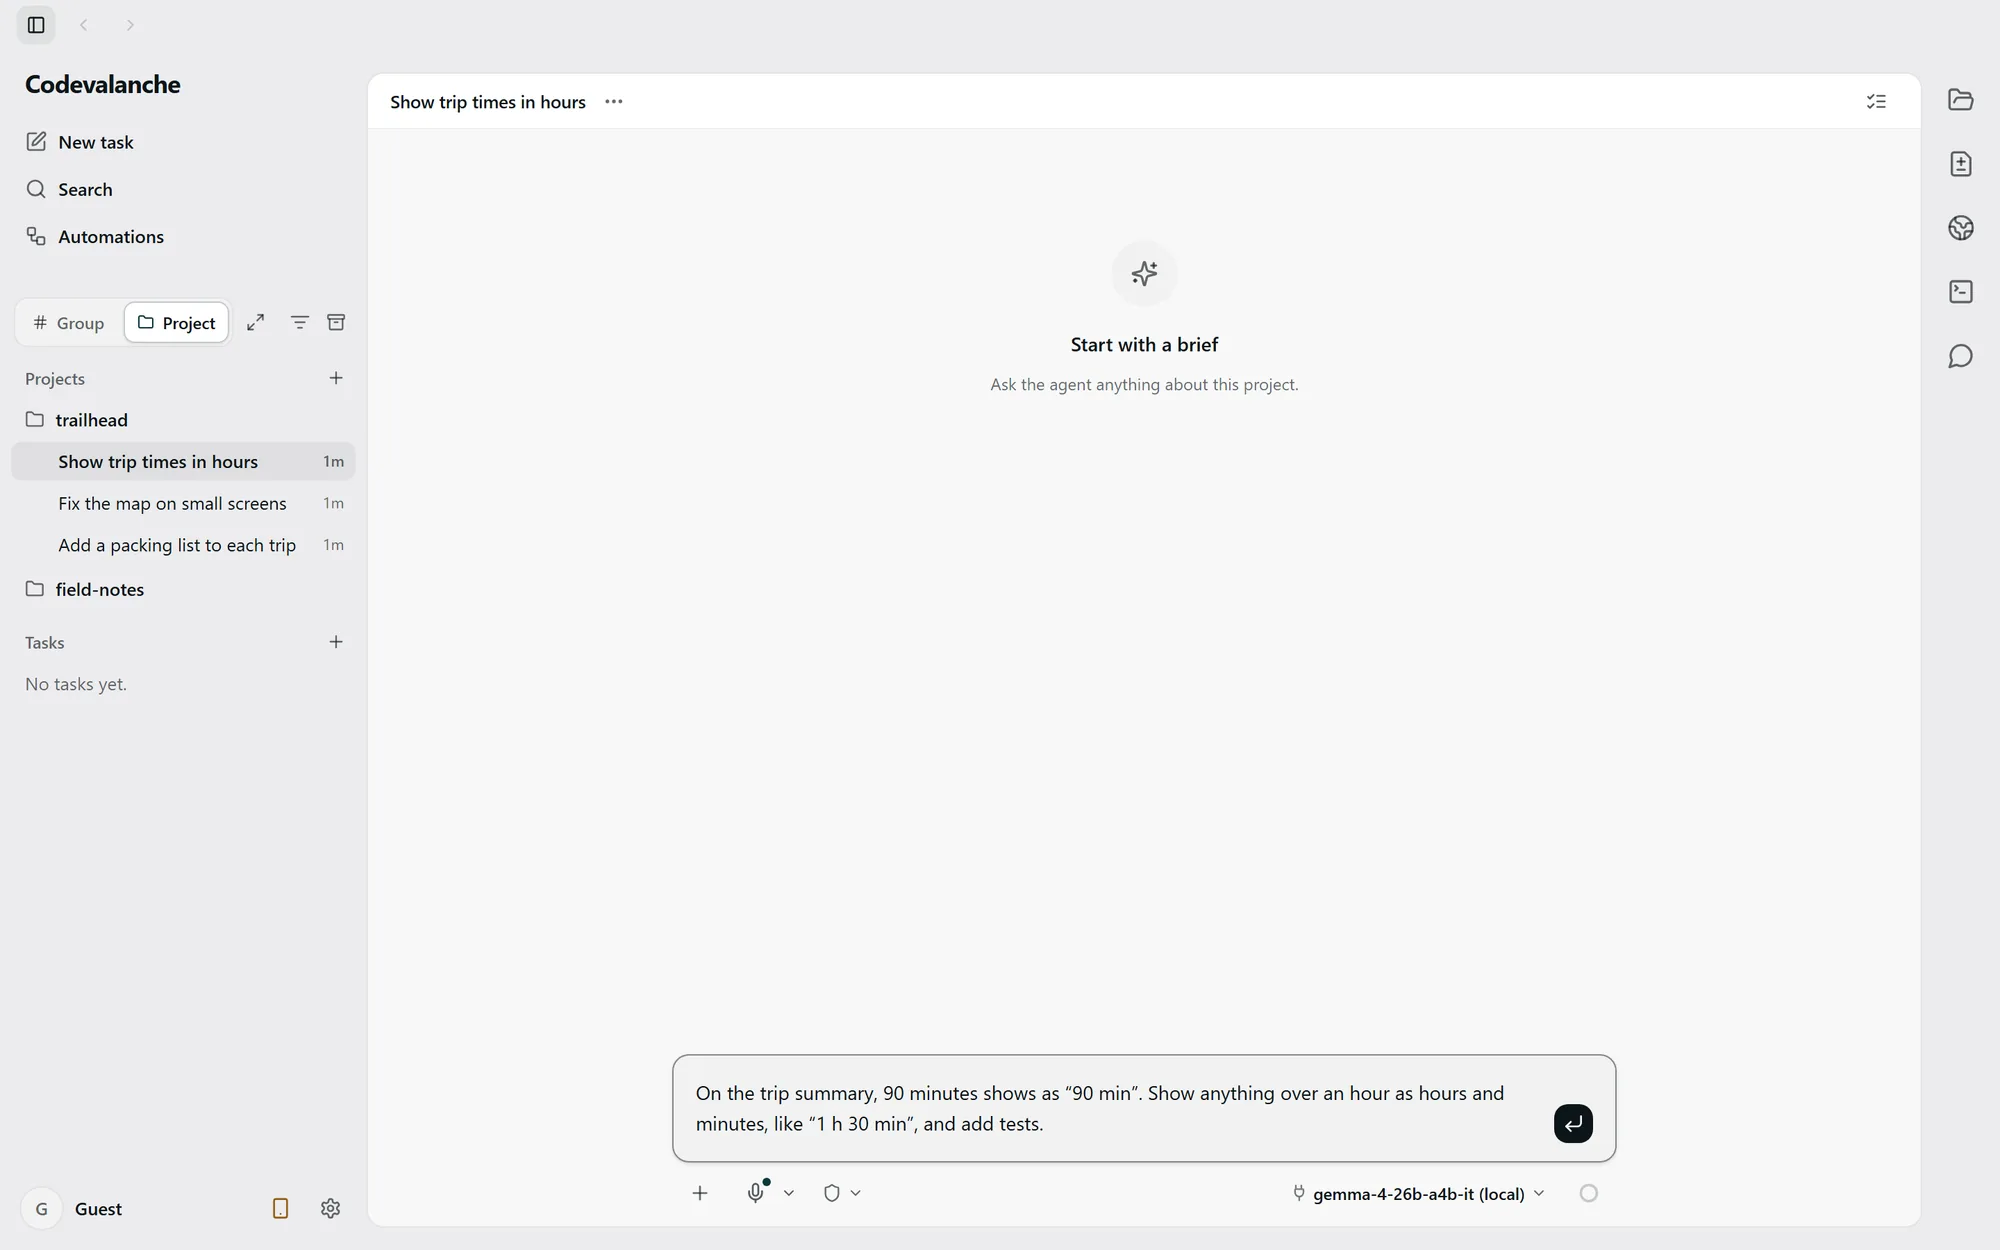
Elige dónde se ejecuta la inferencia.
- Entorno de ejecución local integrado
- Usa un modelo compatible con la versión instalada. La configuración y las descargas del modelo pueden necesitar acceso a la red antes de comenzar la inferencia local.
- LM Studio
- Inicia el servidor local, carga un modelo compatible y configura su punto de conexión en Codevalanche. El servidor debe permanecer disponible durante la tarea.
- Servidor compatible con el formato OpenAI
- Configura la dirección del servidor, el modelo y las credenciales necesarias. La compatibilidad de la API por sí sola no garantiza todas las capacidades de las herramientas o los modelos.
Empieza con una tarea pequeña.
Abre Local Models en Settings para configurar un modelo compatible, o configura la conexión al servidor local. Comprueba el modelo seleccionado antes de enviar una solicitud breve en un proyecto de ejemplo.
Los modelos grandes pueden superar la memoria disponible o ejecutarse demasiado despacio para la tarea. Elige un modelo que tu máquina pueda admitir; no hay un requisito universal de memoria ni una garantía de velocidad.
La inferencia local tiene un límite.
Un modelo que se ejecuta en tu propia máquina realiza allí la inferencia. Las descargas de modelos, las herramientas conectadas y los puntos de conexión externos pueden seguir usando la red. Una dirección de servidor en otra máquina envía las solicitudes a esa máquina.
Elegir un agente en la nube supone una conexión independiente y puede enviar el contexto de la tarea a su proveedor. Comprueba el modelo, el punto de conexión y las herramientas activos antes de usar contenido sensible del proyecto.
Seguridad y límites de los datosSi el modelo local no responde.
- Servidor inaccesible
- Comprueba que el servidor esté en ejecución y que la dirección y el puerto configurados coincidan. Verifica el acceso desde la máquina que ejecuta Codevalanche.
- Modelo no disponible o incompatible
- Carga el modelo deseado en el servidor y comprueba su nombre configurado y sus capacidades compatibles.
- Recursos insuficientes
- Prueba un modelo compatible más pequeño o libera memoria. Comprueba el error del entorno de ejecución antes de repetir la solicitud.