IA local no Codevalanche
Um modelo local, na máquina que você escolher.
Escolha um ambiente de execução local compatível ou um servidor compatível para inferência. O tamanho do modelo, a memória e o hardware determinam se o modelo é adequado para sua tarefa.
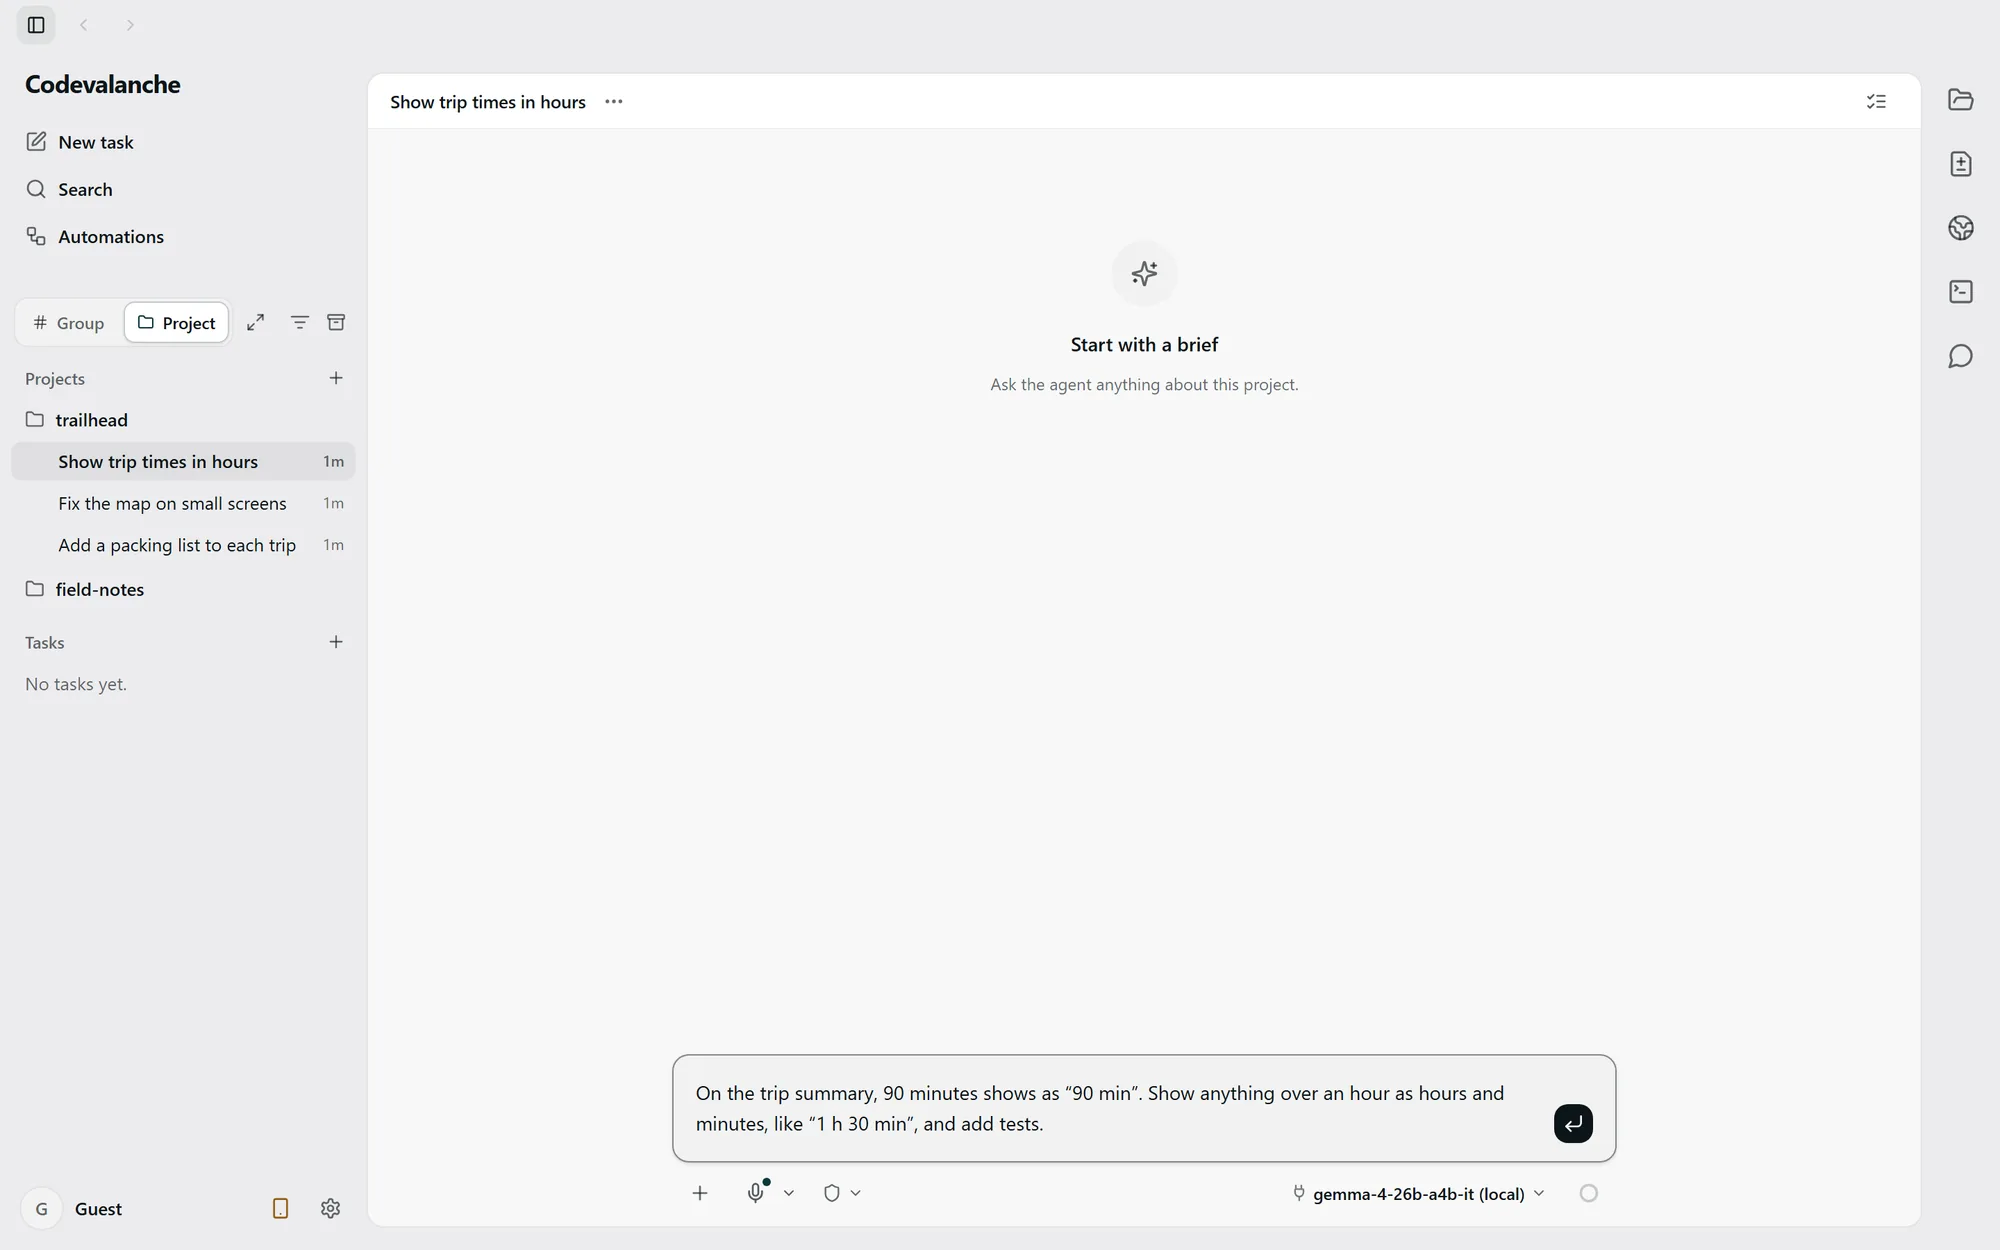
Escolha onde a inferência é executada.
- Ambiente de execução local integrado
- Use um modelo compatível com a versão instalada. A configuração e os downloads do modelo podem precisar de acesso à rede antes que a inferência local comece.
- LM Studio
- Inicie o servidor local, carregue um modelo compatível e configure seu endpoint no Codevalanche. O servidor deve permanecer disponível enquanto a tarefa é executada.
- Servidor compatível com o formato OpenAI
- Configure o endereço do servidor, o modelo e as credenciais necessárias. A compatibilidade com a API, por si só, não garante todos os recursos das ferramentas ou dos modelos.
Comece com uma tarefa pequena.
Abra Local Models em Settings para configurar um modelo compatível ou configure a conexão com seu servidor local. Verifique o modelo selecionado antes de enviar uma solicitação curta em um projeto de exemplo.
Modelos grandes podem exceder a memória disponível ou ser lentos demais para a tarefa. Escolha um modelo que sua máquina consiga executar; não há requisito universal de memória nem garantia de velocidade.
A inferência local tem um limite.
Um modelo executado na sua própria máquina realiza a inferência nela. Downloads de modelos, ferramentas conectadas e endpoints externos ainda podem usar a rede. Um endereço de servidor em outra máquina envia as solicitações para essa máquina.
Escolher um agente na nuvem é uma conexão separada e pode enviar o contexto da tarefa ao provedor dele. Verifique o modelo, o endpoint e as ferramentas ativos antes de usar conteúdo sensível do projeto.
Segurança e limites dos dadosSe o modelo local não responder.
- Servidor inacessível
- Verifique se o servidor está em execução e se o endereço e a porta configurados correspondem a ele. Verifique o acesso a partir da máquina que executa o Codevalanche.
- Modelo indisponível ou incompatível
- Carregue o modelo desejado no servidor e verifique seu nome configurado e os recursos compatíveis.
- Recursos insuficientes
- Tente um modelo compatível menor ou libere memória. Verifique o erro do ambiente de execução antes de repetir a solicitação.