CodevalancheのローカルAI
選んだマシンで動く、ローカルモデル。
対応するローカルランタイムまたは互換サーバーを選んで推論を実行します。モデルのサイズ、メモリ、ハードウェアによって、そのモデルがタスクに適しているかどうかが決まります。
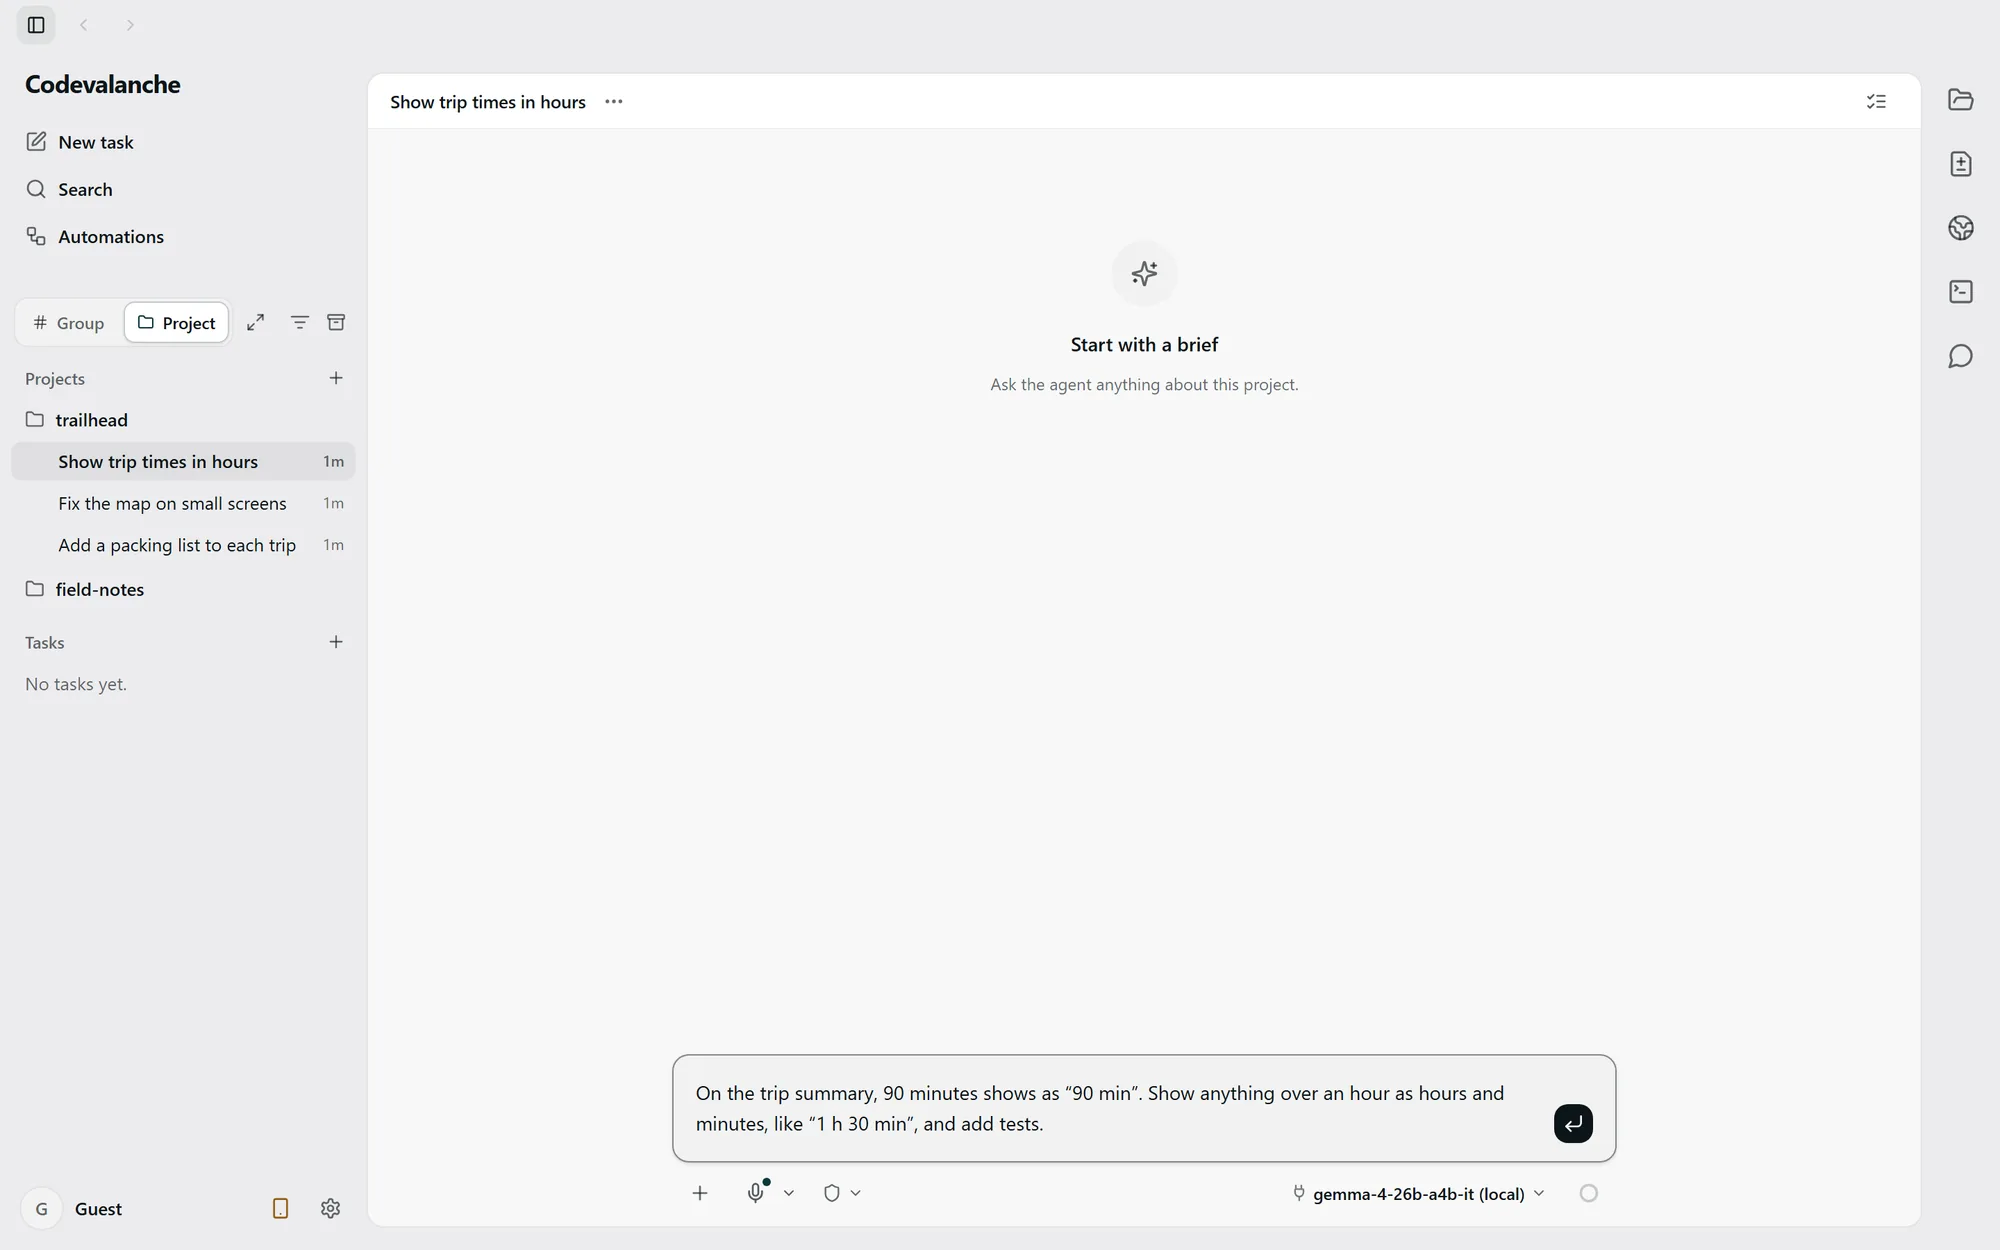
推論を実行する場所を選ぶ。
- 内蔵ローカルランタイム
- インストール済みのビルドが対応するモデルを使ってください。ローカル推論を始める前のモデル設定やダウンロードには、ネットワークアクセスが必要な場合があります。
- LM Studio
- ローカルサーバーを起動し、互換性のあるモデルを読み込み、Codevalancheでエンドポイントを設定してください。タスクの実行中は、サーバーが利用可能な状態を保つ必要があります。
- OpenAI形式の互換サーバー
- サーバーアドレス、モデル、必要な認証情報を設定してください。APIに互換性があっても、すべてのツールやモデルの機能が使えるとは限りません。
小さなタスクから始めましょう。
設定の「ローカルモデル」を開いて対応モデルを設定するか、ローカルサーバーへの接続を設定してください。サンプルプロジェクトで短い依頼を送る前に、選択したモデルを確認してください。
大規模なモデルは利用可能なメモリを超えたり、タスクには遅すぎたりする場合があります。ご自身のマシンで扱えるモデルを選択してください。共通のメモリ要件や速度の保証はありません。
ローカル推論にも境界があります。
自分のマシンで動くモデルは、そのマシン上で推論を行います。モデルのダウンロード、接続したツール、外部エンドポイントでは、引き続きネットワークを使う場合があります。別のマシンのサーバーアドレスを指定すると、そのマシンにリクエストが送信されます。
クラウドエージェントの選択は別の接続であり、タスクのコンテキストがそのプロバイダーに送信される場合があります。機密性の高いプロジェクトの内容を扱う前に、現在のモデル、エンドポイント、ツールを確認してください。
セキュリティとデータの境界ローカルモデルが応答しない場合。
- サーバーに接続できない
- サーバーが起動していることと、設定したアドレスとポートが一致していることを確認してください。Codevalancheを実行するマシンからアクセスできるか確認します。
- モデルが利用できない、または互換性がない
- 使用するモデルをサーバーに読み込み、設定された名前と対応機能を確認してください。
- リソース不足
- 対応する小さめのモデルを試すか、メモリを解放してください。依頼を繰り返す前に、ランタイムのエラーを確認します。