IA locale in Codevalanche
Un modello locale, sulla macchina che scegli.
Scegli un ambiente di esecuzione locale supportato o un server compatibile per l’inferenza. Dimensioni del modello, memoria e hardware determinano se il modello è adatto alla tua attività.
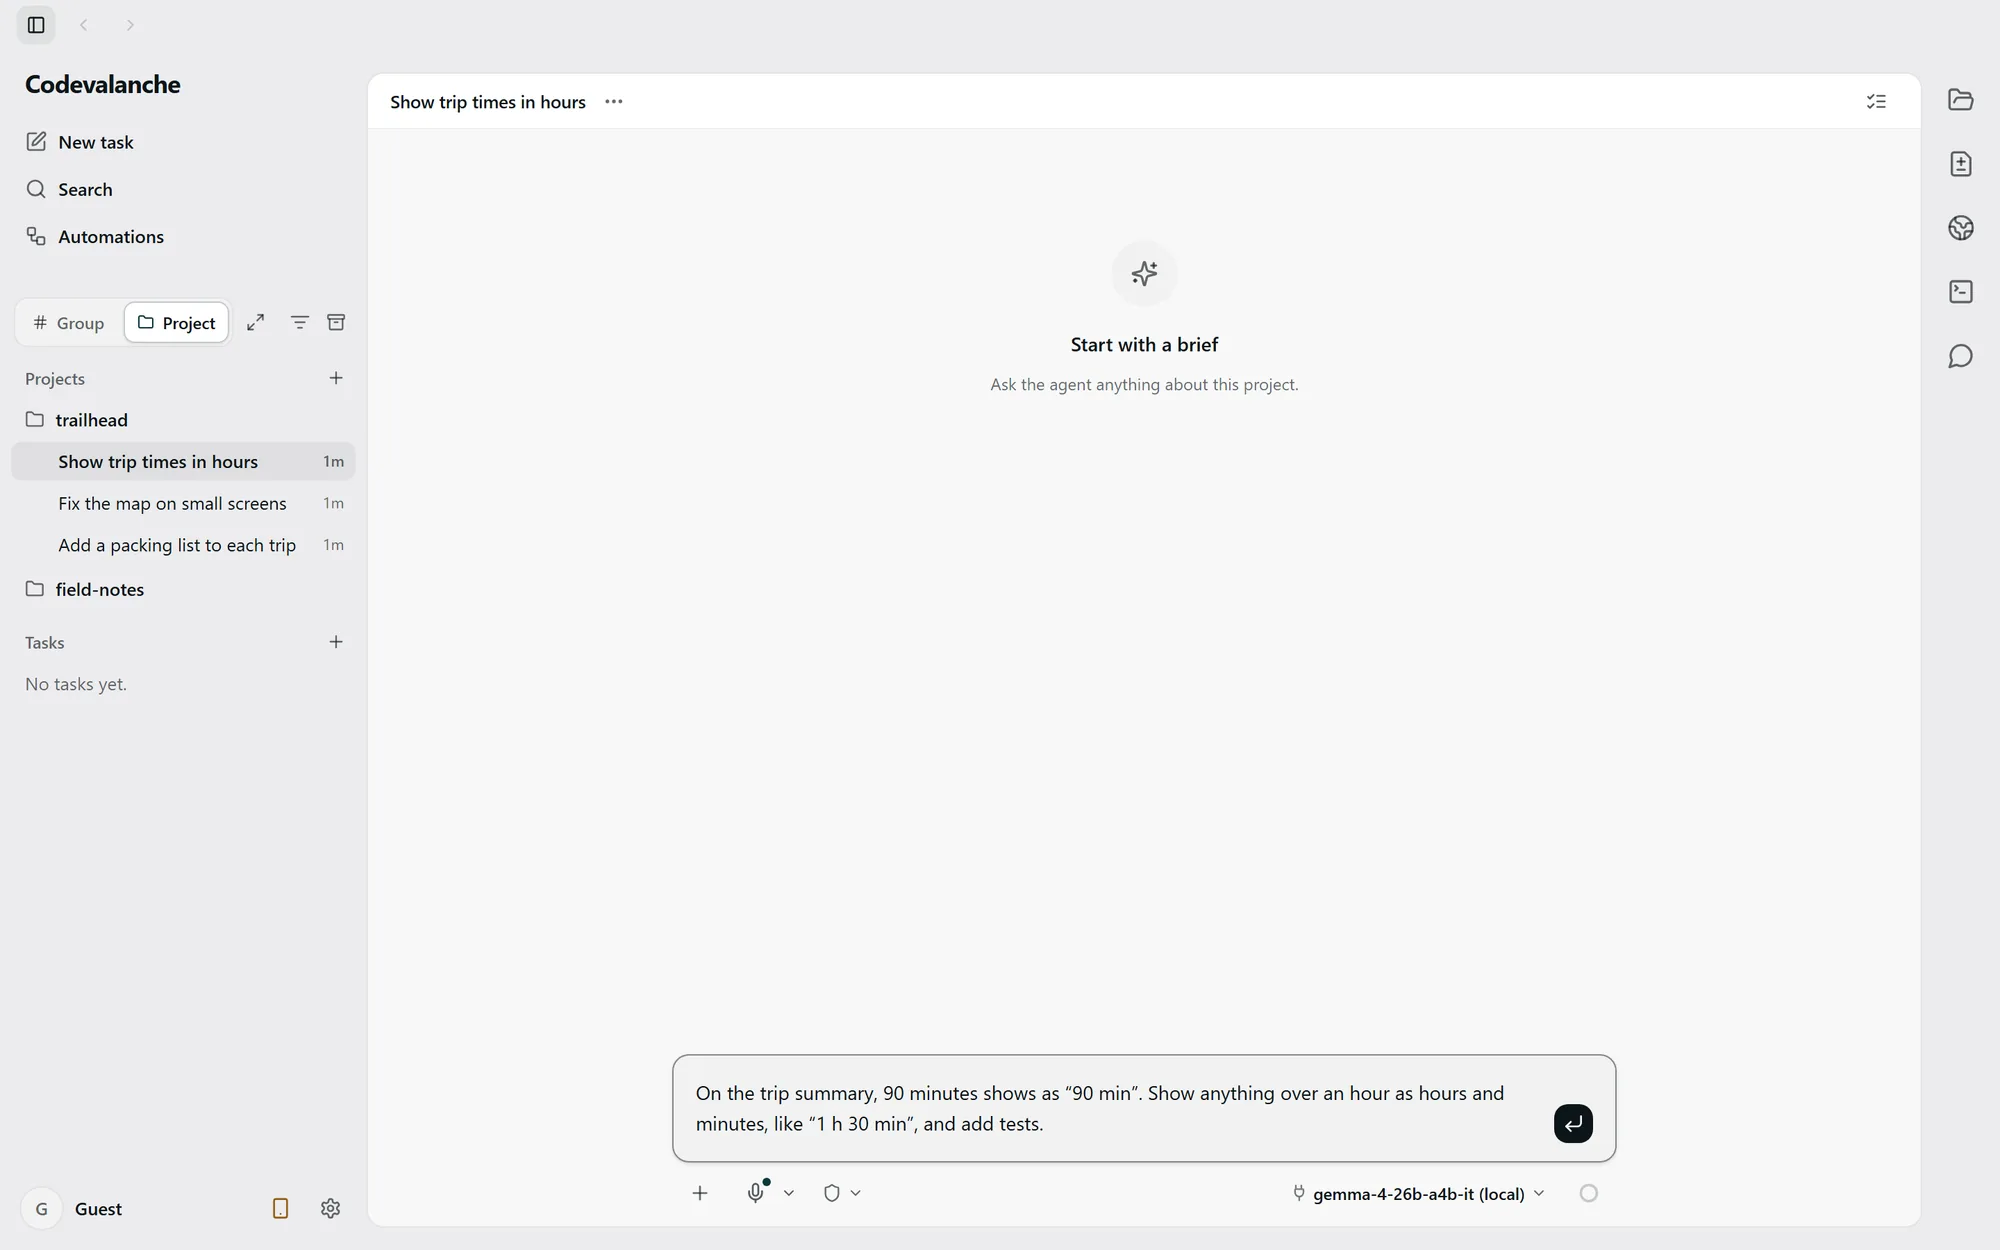
Scegli dove eseguire l’inferenza.
- Ambiente di esecuzione locale integrato
- Usa un modello supportato dalla versione installata. Configurazione e download del modello possono richiedere accesso alla rete prima che inizi l’inferenza locale.
- LM Studio
- Avvia il server locale, carica un modello compatibile e configura il suo endpoint in Codevalanche. Il server deve restare disponibile durante l’attività.
- Server compatibile con il formato OpenAI
- Configura l’indirizzo del server, il modello e le credenziali richieste. La sola compatibilità API non garantisce tutte le capacità degli strumenti o dei modelli.
Inizia con una piccola attività.
Apri Local Models in Settings per configurare un modello supportato, oppure configura la connessione al server locale. Controlla il modello selezionato prima di inviare una breve richiesta in un progetto di esempio.
I modelli grandi possono superare la memoria disponibile o essere troppo lenti per l’attività. Scegli un modello che la tua macchina possa gestire; non esistono un requisito universale di memoria o una garanzia di velocità.
L’inferenza locale ha un confine.
Un modello in esecuzione sul tuo computer esegue lì l’inferenza. Il download dei modelli, gli strumenti collegati e gli endpoint esterni possono comunque usare la rete. Un indirizzo server su un’altra macchina invia le richieste a quella macchina.
La scelta di un agente cloud è una connessione separata e può inviare il contesto dell’attività al suo fornitore. Controlla modello, endpoint e strumenti attivi prima di usare contenuti sensibili del progetto.
Sicurezza e confini dei datiSe il modello locale non risponde.
- Server irraggiungibile
- Verifica che il server sia in esecuzione e che indirizzo e porta configurati corrispondano. Verifica l’accesso dalla macchina su cui è in esecuzione Codevalanche.
- Modello non disponibile o incompatibile
- Carica sul server il modello desiderato e controlla il nome configurato e le capacità supportate.
- Risorse insufficienti
- Prova un modello supportato più piccolo o libera memoria. Controlla l’errore dell’ambiente di esecuzione prima di ripetere la richiesta.