L’IA locale dans Codevalanche
Un modèle local, sur la machine de votre choix.
Choisissez un environnement d’exécution local pris en charge ou un serveur compatible pour l’inférence. La taille du modèle, la mémoire et le matériel déterminent si le modèle convient à votre tâche.
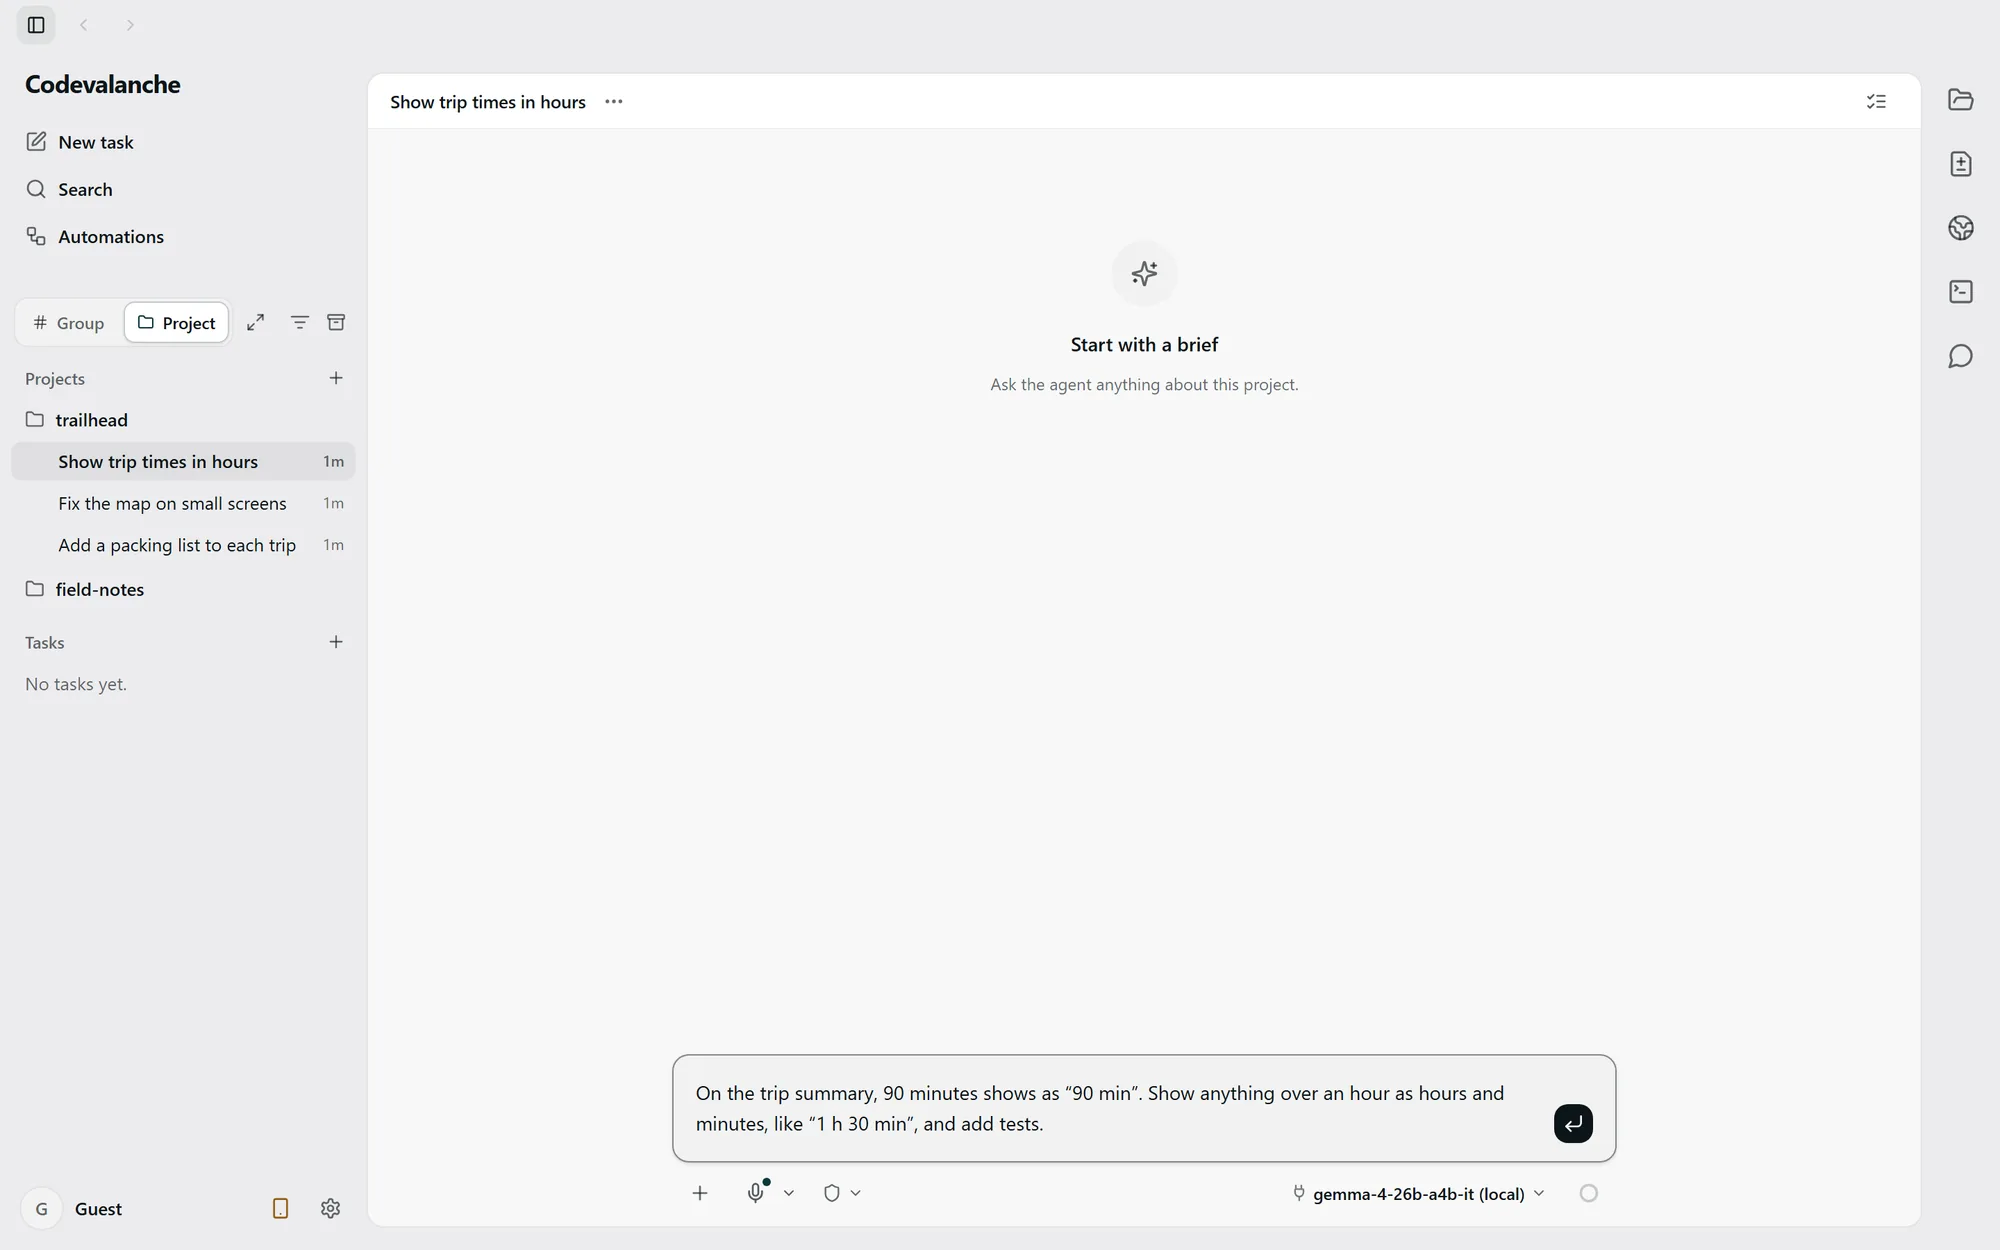
Choisissez où s’exécute l’inférence.
- Environnement d’exécution local intégré
- Utilisez un modèle pris en charge par la version installée. La configuration et les téléchargements du modèle peuvent nécessiter un accès réseau avant le début de l’inférence locale.
- LM Studio
- Démarrez le serveur local, chargez un modèle compatible et configurez son point de terminaison dans Codevalanche. Le serveur doit rester disponible pendant la tâche.
- Serveur compatible avec le format OpenAI
- Configurez l’adresse du serveur, le modèle et les identifiants requis. La compatibilité API seule ne garantit pas toutes les capacités des outils ou des modèles.
Commencez par une petite tâche.
Ouvrez Local Models dans Settings pour configurer un modèle pris en charge, ou configurez la connexion à votre serveur local. Vérifiez le modèle sélectionné avant d’envoyer une courte demande dans un projet d’exemple.
Les grands modèles peuvent dépasser la mémoire disponible ou être trop lents pour la tâche. Choisissez un modèle adapté à votre machine ; il n’existe ni exigence mémoire universelle ni garantie de vitesse.
L’inférence locale a une limite.
Un modèle exécuté sur votre propre machine y effectue l’inférence. Les téléchargements de modèles, les outils connectés et les points de terminaison externes peuvent toujours utiliser le réseau. Une adresse de serveur sur une autre machine envoie les requêtes à cette machine.
Choisir un agent cloud constitue une connexion distincte et peut envoyer le contexte de la tâche à son fournisseur. Vérifiez le modèle, le point de terminaison et les outils actifs avant d’utiliser du contenu sensible du projet.
Sécurité et limites des donnéesSi le modèle local ne répond pas.
- Serveur inaccessible
- Vérifiez que le serveur fonctionne et que l’adresse et le port configurés correspondent. Vérifiez l’accès depuis la machine qui exécute Codevalanche.
- Modèle indisponible ou incompatible
- Chargez le modèle souhaité sur le serveur et vérifiez son nom configuré et ses capacités prises en charge.
- Ressources insuffisantes
- Essayez un modèle pris en charge plus petit ou libérez de la mémoire. Vérifiez l’erreur de l’environnement d’exécution avant de répéter la demande.