Lokale KI in Codevalanche
Ein lokales Modell auf dem Rechner deiner Wahl.
Wähle eine unterstützte lokale Laufzeitumgebung oder einen kompatiblen Server für die Inferenz. Modellgröße, Arbeitsspeicher und Hardware bestimmen, ob das Modell für deine Aufgabe geeignet ist.
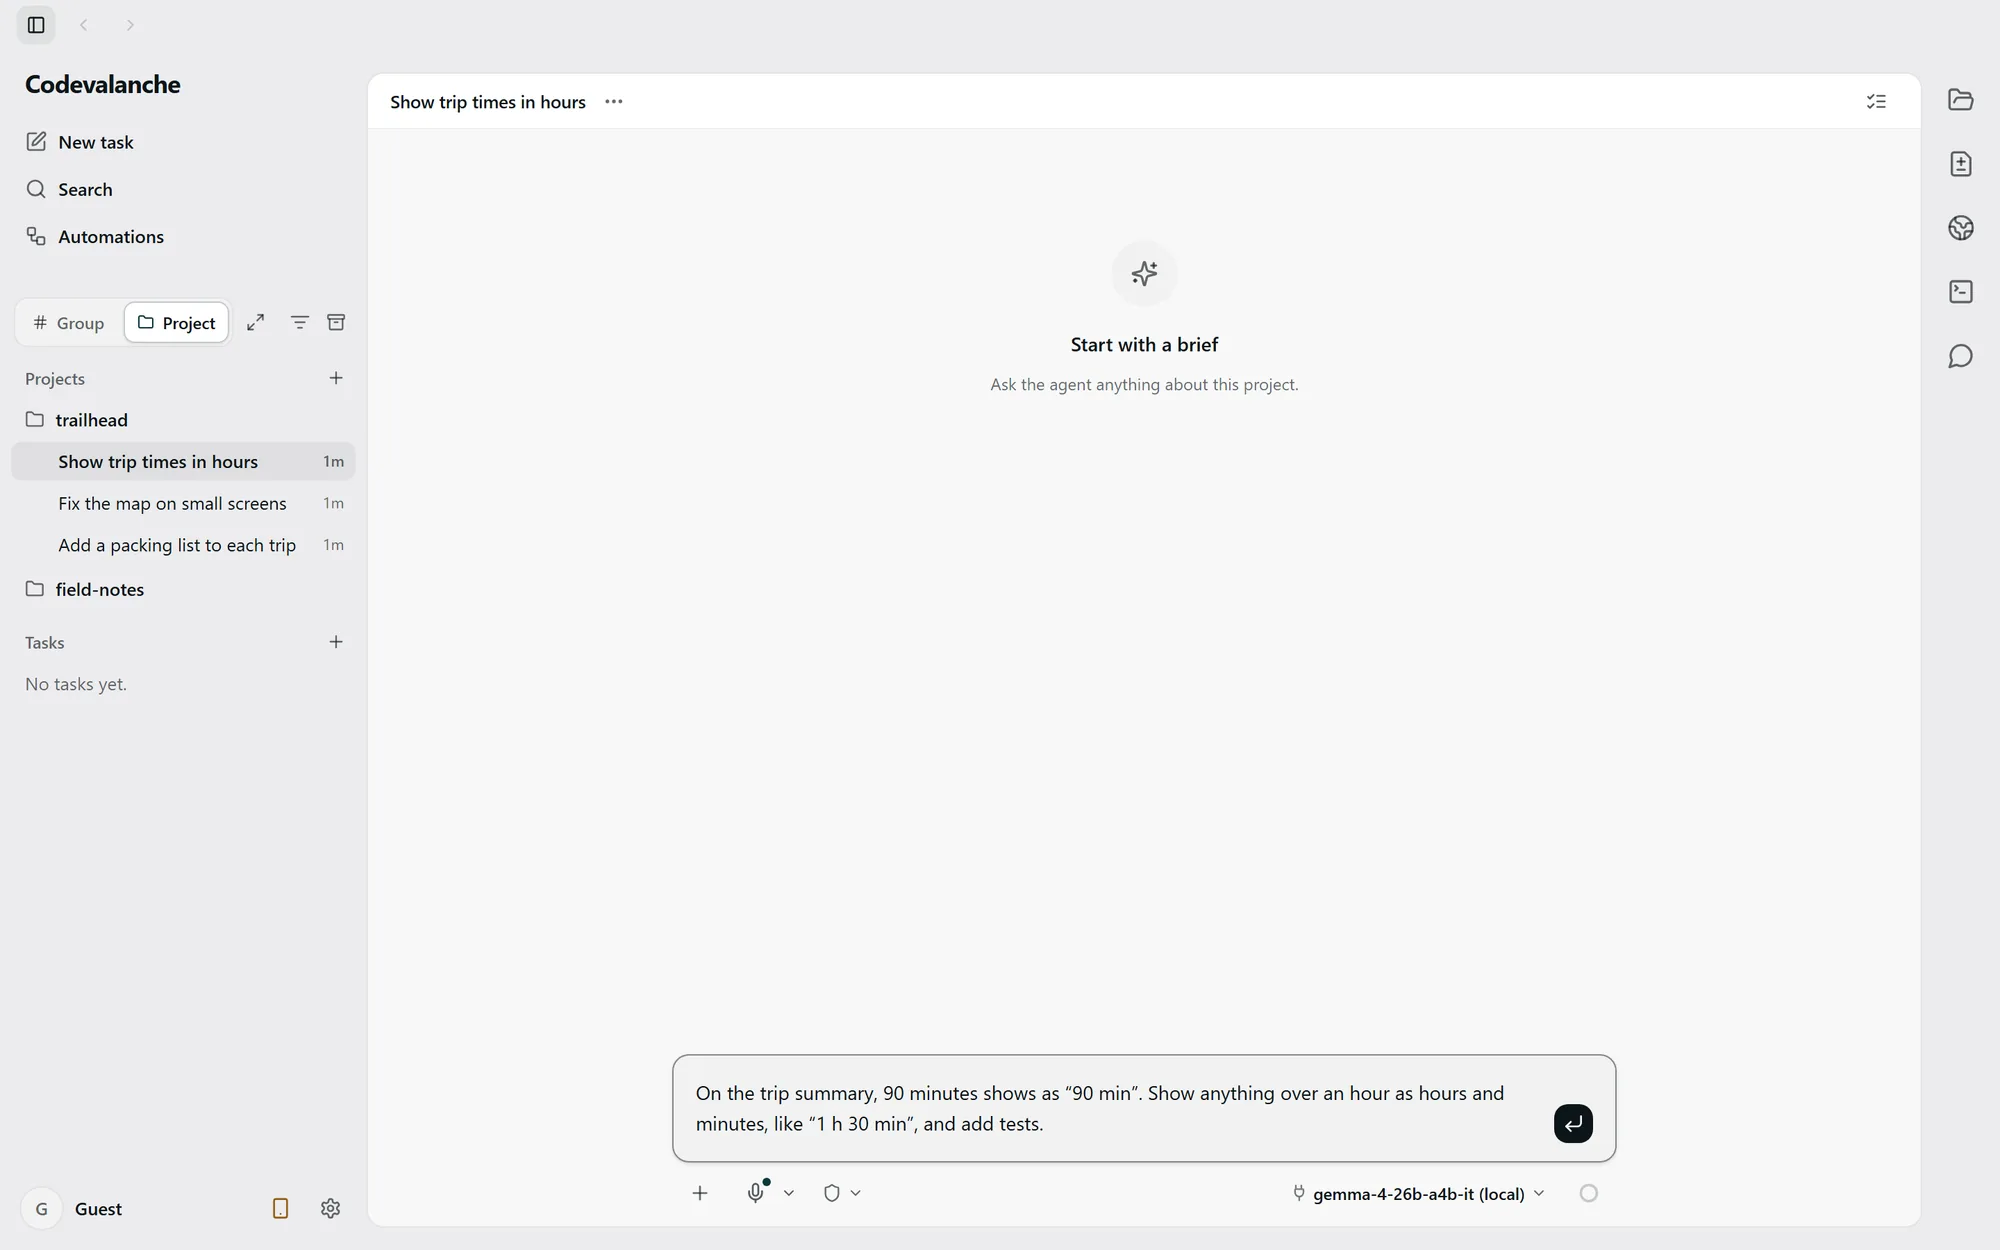
Wähle, wo die Inferenz läuft.
- Integrierte lokale Laufzeitumgebung
- Nutze ein Modell, das die installierte Version unterstützt. Modelleinrichtung und Downloads können Netzwerkzugriff erfordern, bevor lokale Inferenz beginnen kann.
- LM Studio
- Starte den lokalen Server, lade ein kompatibles Modell und konfiguriere seinen Endpunkt in Codevalanche. Der Server muss während der Aufgabe verfügbar bleiben.
- Kompatibler Server im OpenAI-Format
- Konfiguriere Serveradresse, Modell und alle erforderlichen Zugangsdaten. API-Kompatibilität allein garantiert nicht jede Werkzeug- oder Modellfähigkeit.
Beginne mit einer kleinen Aufgabe.
Öffne Local Models in Settings, um ein unterstütztes Modell einzurichten, oder konfiguriere die Verbindung zu deinem lokalen Server. Prüfe das gewählte Modell, bevor du eine kurze Anfrage in einem Beispielprojekt sendest.
Große Modelle können den verfügbaren Arbeitsspeicher überschreiten oder für die Aufgabe zu langsam laufen. Wähle ein Modell, das dein Rechner unterstützt; es gibt keine universelle Speicheranforderung oder Geschwindigkeitsgarantie.
Lokale Inferenz hat eine Grenze.
Ein Modell auf deinem eigenen Rechner führt dort die Inferenz aus. Modelldownloads, verbundene Werkzeuge und externe Endpunkte können weiterhin das Netzwerk nutzen. Eine Serveradresse auf einem anderen Rechner sendet Anfragen an diesen Rechner.
Die Wahl eines Cloud-Agenten ist eine separate Verbindung und kann Aufgabenkontext an dessen Anbieter senden. Prüfe das aktive Modell, den Endpunkt und die Werkzeuge, bevor du sensible Projektinhalte verwendest.
Sicherheit und DatengrenzenWenn das lokale Modell nicht antwortet.
- Server nicht erreichbar
- Prüfe, ob der Server läuft und die konfigurierte Adresse und der Port stimmen. Prüfe den Zugriff vom Rechner aus, auf dem Codevalanche läuft.
- Modell nicht verfügbar oder inkompatibel
- Lade das gewünschte Modell auf dem Server und prüfe seinen konfigurierten Namen und die unterstützten Fähigkeiten.
- Nicht genügend Ressourcen
- Versuche ein kleineres unterstütztes Modell oder gib Arbeitsspeicher frei. Prüfe den Fehler der Laufzeitumgebung, bevor du die Anfrage wiederholst.