Codevalanche의 로컬 AI
원하는 컴퓨터에서 실행하는 로컬 모델.
추론에 사용할 지원 로컬 런타임이나 호환 서버를 선택하세요. 모델 크기, 메모리, 하드웨어에 따라 해당 모델이 작업에 적합한지가 결정됩니다.
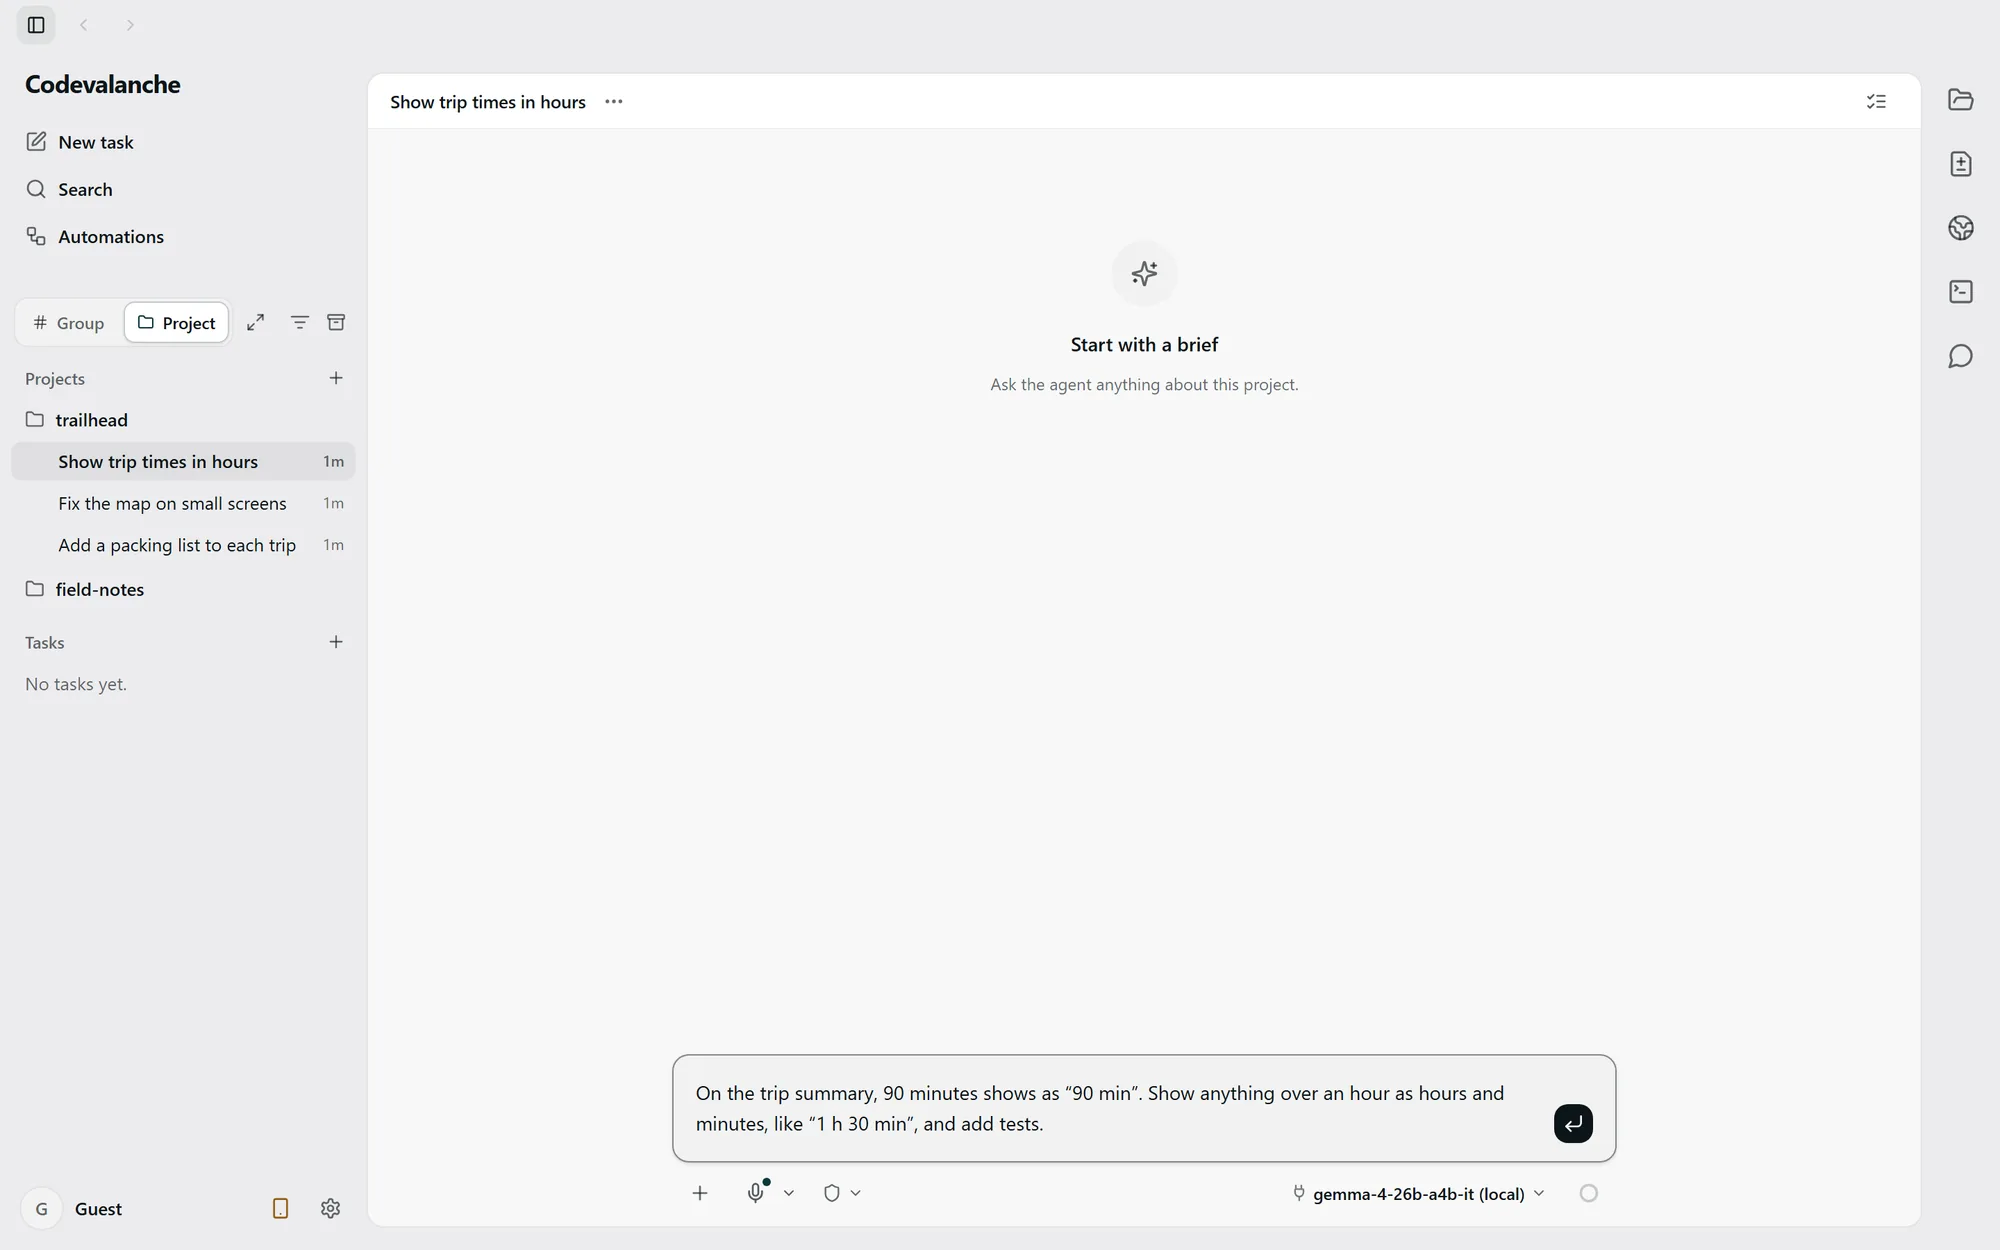
추론을 실행할 위치를 선택하세요.
- 내장 로컬 런타임
- 설치된 빌드가 지원하는 모델을 사용하세요. 로컬 추론을 시작하기 전 모델 설정과 다운로드에 네트워크 접근이 필요할 수 있습니다.
- LM Studio
- 로컬 서버를 시작하고 호환 모델을 로드한 다음 Codevalanche에서 엔드포인트를 설정하세요. 작업이 실행되는 동안 서버를 계속 사용할 수 있어야 합니다.
- OpenAI 형식 호환 서버
- 서버 주소, 모델, 필요한 인증 정보를 설정하세요. API 호환성만으로 모든 도구나 모델 기능이 보장되지는 않습니다.
작은 작업부터 시작하세요.
설정에서 로컬 모델을 열어 지원 모델을 설정하거나, 로컬 서버 연결을 설정하세요. 예시 프로젝트에서 짧은 요청을 보내기 전에 선택된 모델을 확인하세요.
큰 모델은 사용 가능한 메모리를 초과하거나 작업에 쓰기에는 너무 느릴 수 있습니다. 컴퓨터에서 지원할 수 있는 모델을 선택하세요. 모든 모델에 공통으로 적용되는 메모리 요구 사항이나 속도 보장은 없습니다.
로컬 추론에도 경계가 있습니다.
내 컴퓨터에서 실행되는 모델은 그 컴퓨터에서 추론을 수행합니다. 모델 다운로드, 연결된 도구, 외부 엔드포인트는 여전히 네트워크를 사용할 수 있습니다. 다른 컴퓨터의 서버 주소를 지정하면 해당 컴퓨터로 요청이 전송됩니다.
클라우드 에이전트를 선택하면 별도의 연결을 사용하며 작업 맥락이 해당 제공업체로 전송될 수 있습니다. 민감한 프로젝트 내용을 사용하기 전에 현재 모델, 엔드포인트, 도구를 확인하세요.
보안과 데이터 경계로컬 모델이 응답하지 않을 때.
- 서버에 연결할 수 없음
- 서버가 실행 중인지, 설정된 주소와 포트가 서버와 일치하는지 확인하세요. Codevalanche를 실행하는 컴퓨터에서 접근할 수 있는지도 확인하세요.
- 모델을 사용할 수 없거나 호환되지 않음
- 서버에서 사용할 모델을 로드하고 설정된 이름과 지원 기능을 확인하세요.
- 자원 부족
- 지원되는 더 작은 모델을 사용하거나 메모리를 확보하세요. 요청을 반복하기 전에 런타임의 오류를 확인하세요.